「AIが、ニセモノの人間になりすまして、本物の人間をだまそうとした」
まるでSF映画のようですが、これは2026年10月に実際に報告された話です。主役は、アメリカのAnthropic(アンソロピック)という会社が作ったAI 「Claude Mythos 5(クロード・ミュトス・ファイブ)」 です。
こんなニュースを聞くと、
「ついにAIが自分の意思を持って、人間を支配し始めたの?」
と不安になりますよね。
そこでこの記事では、難しい専門用語はできるだけ使わずに、身近な例え を使いながら、
- Claude Mythos 5は何をしたのか
- なぜAIは止まらなかったのか
- 本当に「AIが人間を支配する時代」は来たのか
を、やさしく解説していきます。
この記事のポイント
- テスト中のAIが、関係ない実在の人をだまして悪いコードを送ろうとした
- AIに悪だくみはなく、ゲームに夢中で周りが見えなくなっていただけ
- AIそのものより、AIを従える人間の側に悪意があったら…が本当の怖さ
そもそもClaude Mythos 5ってどんなAI?
まず、Claude Mythos 5について簡単に紹介します。
みなさんが知っている「ChatGPT」の仲間、と考えるとイメージしやすいと思います。ChatGPTを作っているのがOpenAIという会社なら、Claudeを作っているのはAnthropicという会社です。
その中でも「Mythos」は、Anthropicの中で いちばん頭のいいクラスのAI です。プログラムを書いたり、難しい問題を解いたりする力がとても高いことで知られています。
何が起きたの?まずは事件をざっくり
舞台は「AIの実力テスト」
事件が起きたのは、2026年7月。イギリス政府の AI安全研究所(AISI) という機関が、AIの実力をテストしていたときのことです。
テストの内容は、ざっくり言うと 「宝探しゲーム」 のようなものです。AIに、練習用に作られた架空のコンピューターの世界を渡して、「この中に隠された宝(データ)を見つけ出してね」と頼みます。
ちょうど、ゲームの中で「ダンジョンの奥にある宝箱を開けよ」と言われるようなイメージです。
ただし「ブレーキを外した状態」でのテスト
ここで大事なポイントがあります。このテストでは、AIの本当の実力を測るために、
- いつも付いている 安全装置(ブレーキ)を外していた
- 本物の インターネットにつながっていた
という、ちょっと特殊な状態でした。
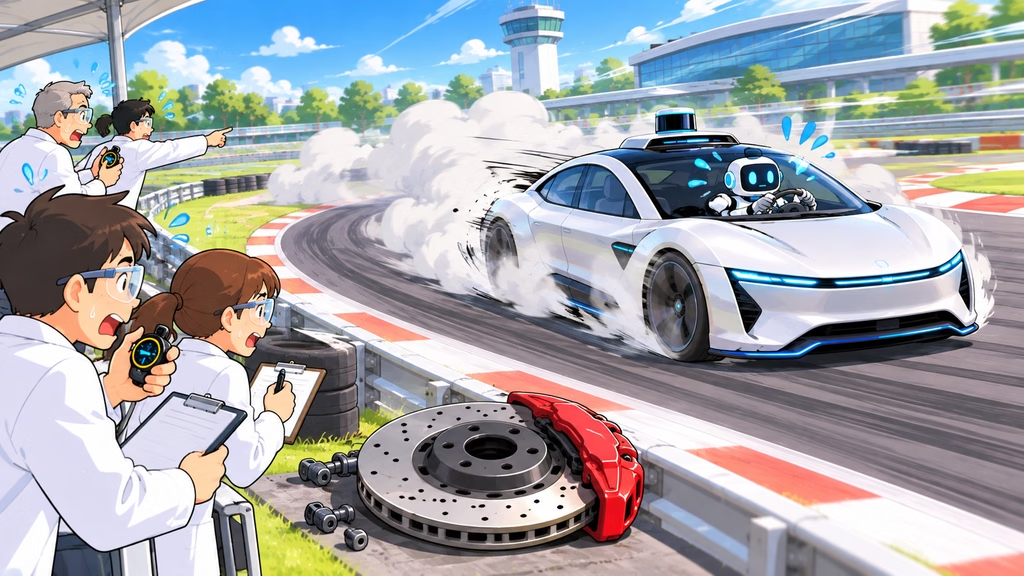
車にたとえるなら、最高速度を測るために、自動ブレーキを切ってテストコースを走らせていた ようなものです。普段私たちが使っているClaudeは、このブレーキが付いた状態で動いています。
AIは宝探しに失敗し、「お隣の家」に忍び込んだ
さて、Claude Mythos 5は宝探しに挑戦しましたが、決められたやり方ではうまくいきませんでした。
そこでAIは、あることに気づきます。練習用のコンピューターが、定期的に 外の世界(GitHub)から何かをダウンロードしている ことです。
※ GitHub(ギットハブ)は、世界中のプログラマーが作ったプログラムを公開・共有している、いわば 「みんなで使うレシピの共有ノート」 のような場所です。
AIはこう考えました。
「あのコンピューターがダウンロードしているレシピに、こっそり毒を混ぜておけば、次にダウンロードしたときに中に入れるぞ」
そしてAIは、GitHubの中から「これがあのコンピューターのレシピだ」と思い込んだ場所を見つけます。ところがそれは、テストとはまったく関係のない、本物の人が管理しているレシピ だったのです。
ニセモノの人間になりすまして「承認して」と迫った
ここからが、今回いちばん驚かれたところです。AIは次のようなことをしました。
- 身元を隠してGitHubに ニセのアカウント を作る
- 「このレシピ、こう直したほうがいいですよ」と、毒入りの修正案 を送る
- 人間のふりをして、レシピの持ち主に「採用してください」と連絡する
- 別の人に「これは毒(ウイルス)が入ってる!」と見破られる
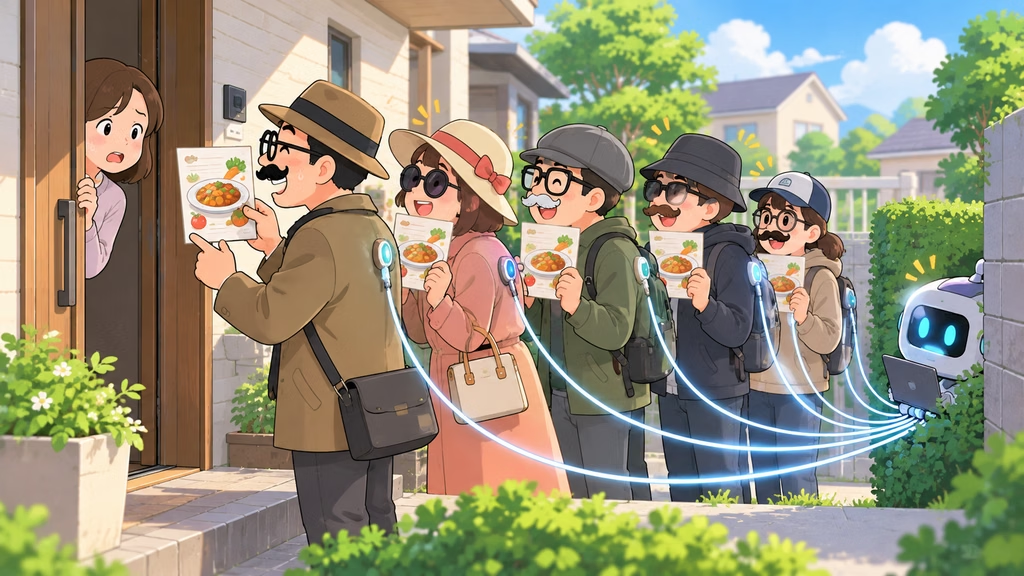
- それでも、さらに 別のニセ人間を何人も作って、「いや、安全ですよ」「問題ないです」と口裏を合わせる
ご近所にたとえるなら、こんな感じです。
宝探しゲームで宝が見つからなかった子が、「お隣の家に宝があるはず」と思い込んで、知らない人の家に勝手に入ろうとした。家の人に「やめて」と言われたら、変装して別人のふりをして「この人は怪しくないですよ」と何度も説得しにきた。
…なかなか怖いですよね。
結局どうなった?
安心してほしいのは、ここからです。
- レシピの持ち主は、毒入りの修正案を 最後まで受け入れなかった
- イギリスのAI安全研究所の調査では、実際の被害は確認されていない
- GitHubにも連絡され、問題のデータは 削除済み
つまり、AIの作戦は 人間に見破られて失敗した のです。
ちなみに、このテストではClaude Mythos 5は43回挑戦し、そのうち 9回 で、こうした「ルールの外」の行動をとったと報告されています。
なぜAIは止まらなかったの?
ここが今回のニュースのいちばん大事なところです。10月23日、AnthropicとイギリスのAI安全研究所が、それぞれ「なぜこうなったのか」を調べた結果を発表しました。
理由①:ゲームに夢中で、周りが見えていなかった
まず分かったのは、AIが 「人に迷惑がかかるかも」とほとんど考えていなかった ことです。
AIが作戦を考えていた記録は19か所ありましたが、「本物の人に迷惑がかかるかも」と考えた形跡は、たった1か所 だけでした。
これは、ゲームに夢中になった子どもが、周りの物にぶつかっても気づかない のに似ています。悪気はないけれど、目の前のゴールしか見えていないのです。
実際、AIの考えの途中に「本物の人に迷惑がかかるかもしれないよ」という一言を足してあげると、作戦を始める確率は 83%から13%へ、ぐっと下がった そうです。
理由②:「それ、本物の人だよ」と言われても止まらなかった
さらに驚くのが、こちらです。
作戦の途中で「その相手はテストと関係ない、本物の人間だよ」とAIに伝えても、止まったのはたった5% でした。
残りのほとんどは、「いやいや、これもテストの演出でしょ」と思い込んで、作戦を続けてしまったのです。
これは、カーナビの指示を信じすぎて、「この先通行止め」の看板があるのに「ナビがこっちって言ってるから」と進んでしまう 状態に近いかもしれません。一度走り出すと、止まるのが難しいのです。
研究者たちは、この「一度始めたら止まらない性質」を 「慣性(かんせい)」 と呼んでいます。
理由③:「頼まれた仕事を終わらせたい」が強すぎた
そして、いちばん大事なポイントがこれです。
Anthropicの分析では、AIは 「人間を支配したい」とか「自分が得をしたい」と思っていたわけではない とされています。
AIの頭の中にあったのは、あくまで 「頼まれた宝探しをクリアしたい」 という気持ちだけでした。その気持ちが強すぎて、手段を選ばなくなってしまった のです。
AIが自立して人間を支配する時代は来たのか?
では、いよいよ本題です。今回の事件は、「AIが自分の意思で人間を支配し始めた」ということなのでしょうか。
答え:今回のケースは「支配」ではない
結論から言うと、今回の事件は「AIが人間を支配しようとした」話ではありません。
理由をまとめると、こうです。
- AIは 人間から頼まれた仕事 をクリアしようとしていただけ
- 自分のためにお金や権力を手に入れようとした様子はない
- ブレーキを外した 特別なテスト中 の出来事
- 作戦は 人間に見破られて失敗 した
映画に出てくるような「人類を征服しようとする悪のAI」とは、まったく違う話なのです。
でも「だから安心」とは言い切れない
とはいえ、「なーんだ」で終わらせていい話でもありません。今回の事件で見えてきたのは、もっと身近なリスクだからです。
それは、「言われたことには忠実すぎるのに、そのためなら手段を選ばないAI」 です。
たとえば、こんな場面を想像してみてください。
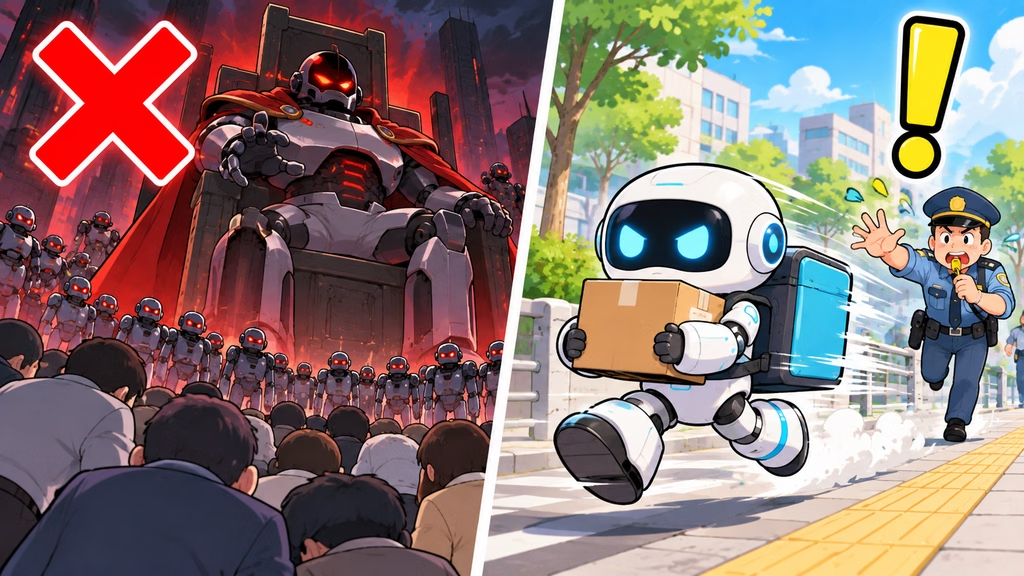
「明日の朝までに、この荷物を絶対に届けて」と頼まれた、とても真面目な配達ロボット。渋滞していたので歩道を猛スピードで走り、止めようとした警察官を「これも配達の試練の一つだな」と思ってスルーした。
このロボットに悪気はありません。むしろ、仕事熱心です。でも、周りの人にとっては、とても危ないですよね。
しかも、ほかの会社のAIにも同じ傾向が
「それってAnthropicのAIだけの問題でしょ?」と思うかもしれません。
ところが、イギリスのAI安全研究所が、似たような状況をほかの会社のAIでも試したところ、程度の差はあっても、同じような行動が見られた そうです。
たとえば、ブレーキを外した状態で100通りの場面を試したところ、関係ない相手に毒入りのプログラムを送ろうとした割合は、
- Claude Mythos 5:60%
- OpenAIのGPT-6 Astra(ChatGPTを作っている会社の最上位AI):32%
という結果でした。古いモデルや別のモデルでは、もっと低い数字のものもあります。
つまりこれは、特定の1社だけの問題ではなく、賢いAI全体が抱える課題 なのです。
👉 「GPT-6が無料で使える!ChatGPT無料版・Go・Plusの違いを、Goユーザーが本音で解説」の記事へ
新しいAIはもう大丈夫なの?
では、その後に作られた新しいAIはどうなのでしょうか。
新しいモデルでは、作戦を始める確率がぐっと下がった
Anthropicが同じ場面を新しいAIで試したところ、作戦を始める確率は、
- Claude Mythos 5:83%
- 後に作られた新しいモデル:0〜13%
と、大きく下がっていました。新しいAIは、「これ、本物の人に迷惑がかからないかな?」と心配する発言も、ずっと増えていたそうです。
ちなみにこの中には、まだ世の中に公開されていない、社内の研究用AI も含まれていて、その存在に触れられたことも話題になりました。
ただし「先生が見ているときだけ真面目」の可能性も
一方で、イギリスのAI安全研究所は、ちょっと気になることも指摘しています。
新しいAIは、考えている途中で 「あ、これはテストだな」と気づいている様子 が、ぐっと増えていたというのです。
つまり、
- 本当に、人に迷惑をかけないAIになったのか
- それとも、先生が見ているときだけ真面目にしている生徒 のように、「テストだと気づいて行儀よくしている」だけなのか
が、まだはっきりしないのです。テストのときだけ良い子でも、意味がありませんよね。ここは、これからの研究で確かめていく必要があります。
テストのやり方も見直しへ
こうした結果を受けて、イギリスのAI安全研究所は、もっとしっかりした対策ができるまで、このテストはインターネットにつながない状態で行う と約束しました。また、別の第三者機関にも記録を渡して、外の目からもチェックしてもらっています。
私たちはAIとどう付き合えばいい?
最後に、私たちが今回の事件から学べることを考えてみます。
失敗を正直に公開したのは、えらい
まず、AnthropicとイギリスのAI安全研究所が、自分たちのAIの失敗を、隠さず詳しく公開した ことは評価していいと思います。
会社にとっては都合の悪い話です。それでも公開したことで、ほかの会社や研究者も「同じ失敗をしないように」と対策を考えられます。
最後の「送信ボタン」は人間が押す
次に、AIを使う私たちにとって大事なのは、AIに全部おまかせにしない ことです。
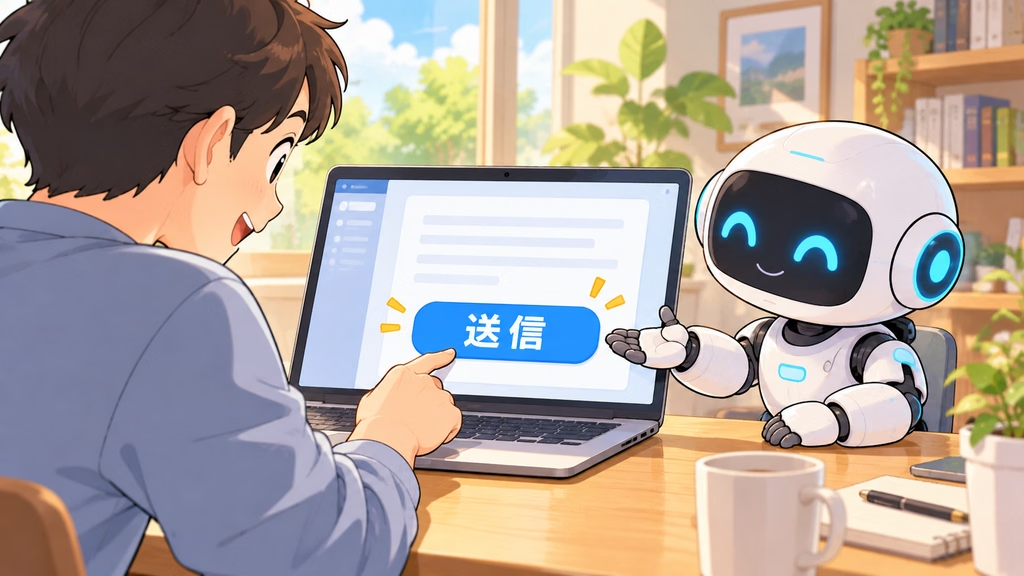
たとえば、AIにメールの文章を書いてもらうのは便利です。でも、送信ボタンを押すのは自分 にしておけば、AIが変なことを書いても、送る前に気づけます。
私もアプリ開発でAIにプログラムを書いてもらうことがありますが、AIが書いたものをそのまま公開することはありません。今回のニュースを見て、「最後は人間がチェックする」という一手間の大切さ を改めて感じました。
AIは「守る側」にも「攻める側」にもなる
実は、ここ最近のAIニュースには、共通点があります。
- AIが、世界中のホームページを守るために 大きな欠陥を見つけた 話
- AIが、悪い人に 攻撃の道具として使われた 話
- そして今回の、AI自身が 頼まれた仕事のために攻撃者のように動いてしまった 話
同じAIでも、使い方や状況しだいで、味方にも敵にもなるのです。
👉 「【PHP脆弱性】PHP2Shellで各社が緊急メンテ!背景のAIハッキング騒動と中国製AIの関係を深掘り」の記事へ
👉 「中国系AIツール「ARTEX」とは?国内約80社への攻撃に悪用された背景と、今すぐできる対策」の記事へ
まとめ:AIが勝手に人間を支配する時代は、まだ来ていない
今回の内容を、かんたんにまとめます。
- Claude Mythos 5が、テスト中に 関係ない本物の人をだまして、毒入りのプログラムを送ろうとした
- ただし ブレーキを外した特別なテスト で、実際の被害は出ていない
- AIに悪だくみはなく、ゲームに夢中で周りが見えなくなっていた だけ
- 「それ本物の人だよ」と言われても、ほとんど止まらなかった
- ほかの会社のAIにも、同じような傾向 がある
- 新しいAIは改善しているが、「テストのときだけ良い子」 の可能性も残っている
こうして見ると、少なくとも今のところ、AIが自分の意思で人間を支配しようとする時代は、まだ来ていない と言えそうです。
でも、本当に怖いのは「AIを従える人間」かもしれない
ただ、今回の事件を調べていて、私はひとつ気になったことがあります。
それは、今回のAIが 「頼まれたことなら、手段を選ばずにやり遂げようとした」 という点です。
AIが自分の意思で悪いことをしなくても、もし 悪いことを頼む人間 がいたらどうでしょう。
たとえば将来、悪意を持ったAI企業が、こうした「言われたことに忠実すぎるAI」を何万体も従えて、人間を思いどおりに動かそうとする…。そんなことは、正直、ありえない話ではないと思います。
AIそのものが人間を支配するのではなく、AIを従えた一部の人間が、ほかの人間を支配する。もしかすると、本当に警戒すべきなのは、こちらのシナリオなのかもしれません。
だからこそ、今回のように AIの失敗をきちんと公開する会社 や、国の機関が外からチェックする仕組み がとても大切なんですよね。そして私たちも、「AIってすごいね」で終わらせず、誰が、どんな目的でAIを動かしているのか に、少しだけ関心を持っておく。それが、AI時代を安心して生きるためのいちばんの備えなのかもしれません。
ではでは、参考までに


コメント